
Código fuente / Templates
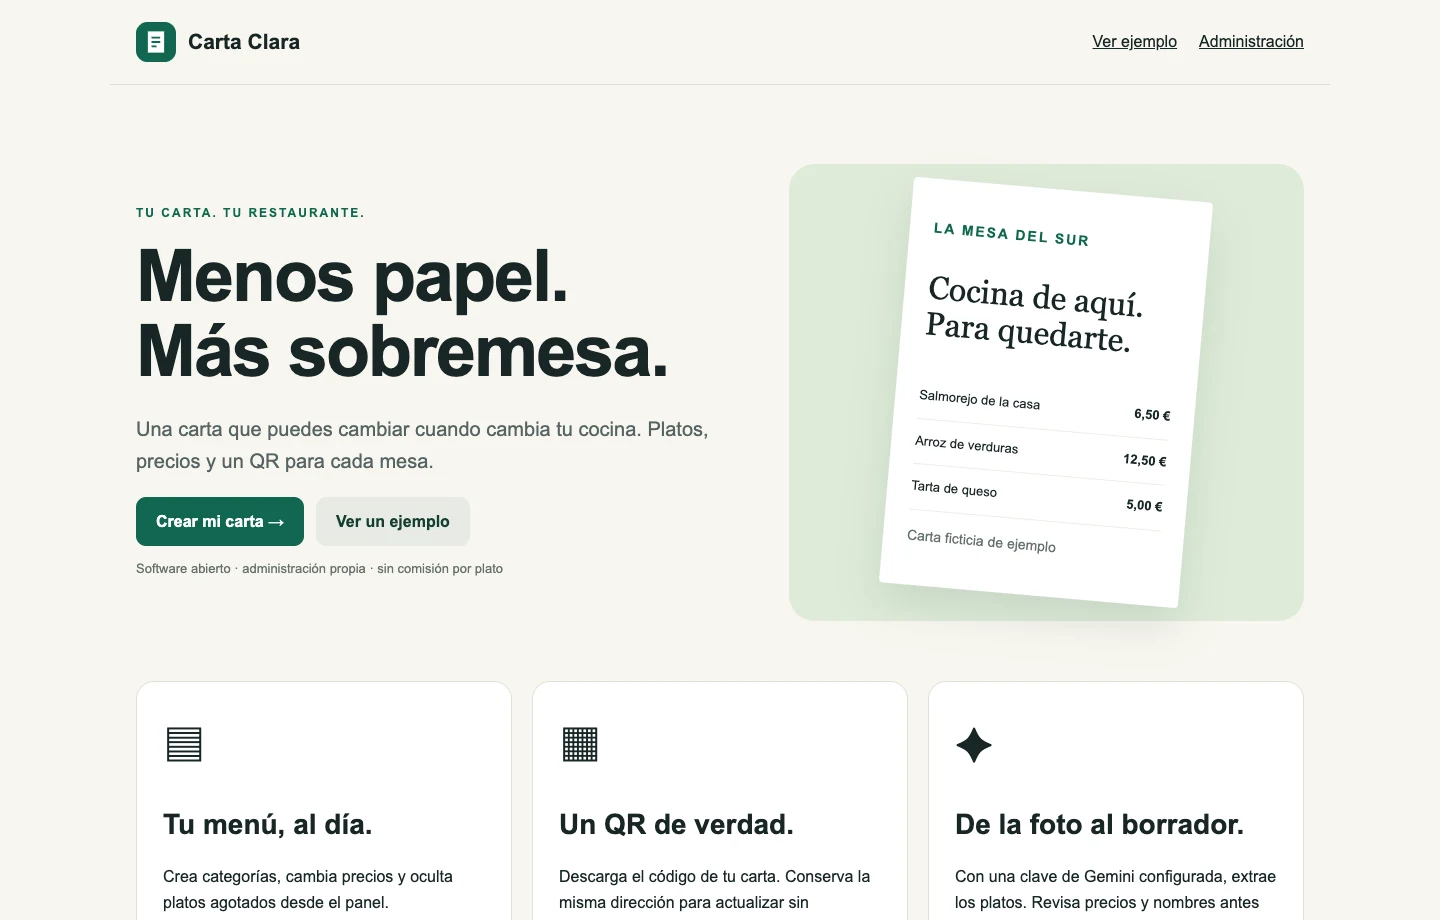
Carta Clara: carta QR, administración y lectura de fotos con Gemini
Una carta QR con panel por restaurante y lectura de fotos mediante Gemini. Código abierto, edición manual y revisión antes de incorporar platos.
Mejora resultados en IA con un pipeline de preprocesamiento: normalización de texto (lowercase, acentos, espacios), tokenización con stopwords y limpieza de datos
La calidad de los datos es crucial para sistemas de IA. En este tutorial aprenderás técnicas de normalización y preprocesamiento que mejoran significativamente los resultados de tus modelos.
public class TextNormalizer
{
    public string Normalize(string text)
    {
        if (string.IsNullOrWhiteSpace(text))
            return string.Empty;

        // 1. Lowercase
        text = text.ToLowerInvariant();

        // 2. Remover acentos
        text = RemoveAccents(text);

        // 3. Remover caracteres especiales
        text = RemoveSpecialCharacters(text);

        // 4. Normalizar espacios
        text = NormalizeWhitespace(text);

        return text.Trim();
    }

    private string RemoveAccents(string text)
    {
        var normalizedString = text.Normalize(NormalizationForm.FormD);
        var stringBuilder = new StringBuilder();

        foreach (var c in normalizedString)
        {
            var unicodeCategory = CharUnicodeInfo.GetUnicodeCategory(c);
            if (unicodeCategory != UnicodeCategory.NonSpacingMark)
            {
                stringBuilder.Append(c);
            }
        }

        return stringBuilder.ToString().Normalize(NormalizationForm.FormC);
    }
}public class Tokenizer
{
private readonly HashSet<string> _stopWords = new()
{
"el", "la", "de", "que", "y", "a", "en", "un", "ser", "se", "no"
};
public List<string> Tokenize(string text, bool removeStopWords = true)
{
var tokens = text
.Split(new[] { ' ', '\t', '\n', '\r', ',', '.', ';', ':', '!', '?' },
StringSplitOptions.RemoveEmptyEntries)
.Select(t => t.ToLowerInvariant())
.Where(t => t.Length > 2);
if (removeStopWords)
{
tokens = tokens.Where(t => !_stopWords.Contains(t));
}
return tokens.ToList();
}
}public class DataCleaner
{
public string CleanBusinessHours(string hours)
{
// Normalizar horarios de negocio
// "Lunes a Viernes: 9-14h" → "L-V: 09:00-14:00"
return hours;
}
public string CleanPhoneNumber(string phone)
{
// Normalizar números de teléfono
// "+34 666 123 456" → "666123456"
return Regex.Replace(phone, @"[^\d]", "");
}
}Palabras clave: data normalization, text preprocessing, tokenization, data cleaning, NLP
Una carta QR con panel por restaurante y lectura de fotos mediante Gemini. Código abierto, edición manual y revisión antes de incorporar platos.
Luca Cantón ha creado LO-E, un hub donde convierte las ideas de videojuegos que le van pasando por la cabeza en siete mundos jugables desde el navegador.
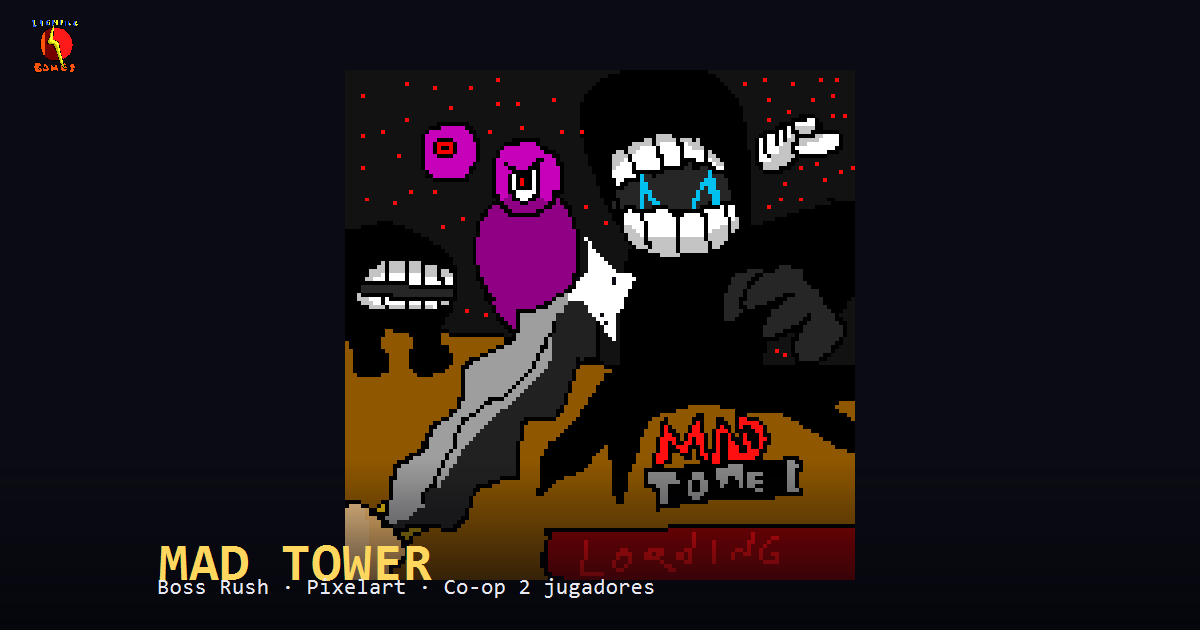
Leo Cantón tiene 14 años y ha convertido el videojuego que llevaba años diseñando en papel en MAD TOWER, un boss rush 2D creado con ayuda de la IA.