
Código fuente / Templates
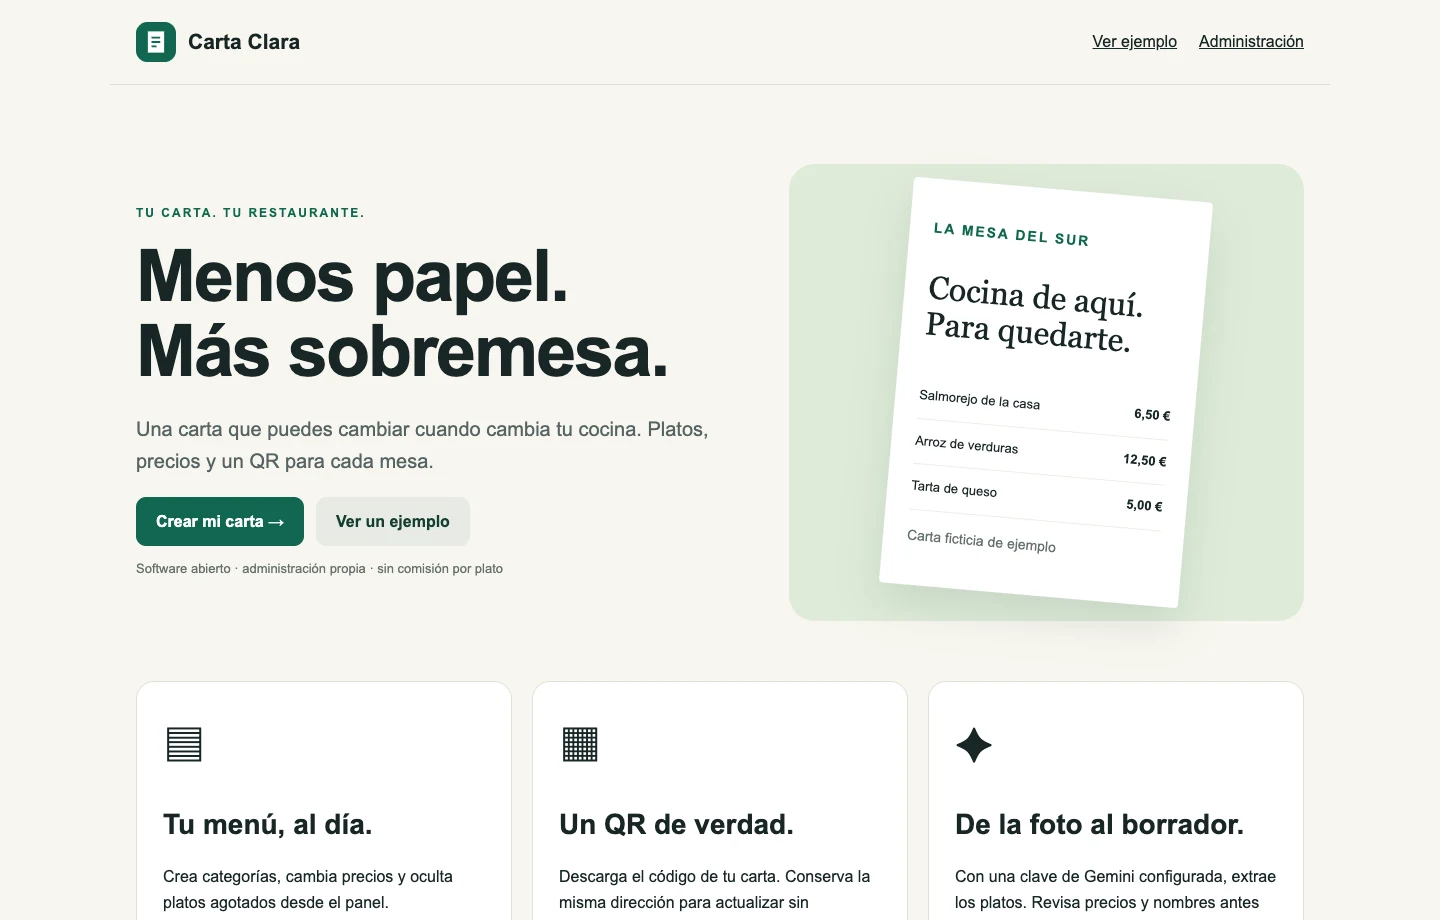
Carta Clara: carta QR, administración y lectura de fotos con Gemini
Una carta QR con panel por restaurante y lectura de fotos mediante Gemini. Código abierto, edición manual y revisión antes de incorporar platos.
Guía práctica para configurar LLMs: temperatura, max_tokens, top_p, frequency/presence penalty y ajustes por caso de uso (chat, clasificación, extracción JSON, resumen).
Los parámetros de configuración de LLMs como temperatura, max_tokens, top_p controlan el comportamiento y la calidad de las respuestas. En este tutorial aprenderás a configurar estos parámetros para diferentes casos de uso.
Controla la aleatoriedad de las respuestas:
// Determinístico (misma respuesta siempre)
var settingsDeterminista = new OpenAIPromptExecutionSettings
{
    Temperature = 0.0
};

// Balanceado
var settingsBalanceado = new OpenAIPromptExecutionSettings
{
    Temperature = 0.7
};

// Muy creativo
var settingsCreativo = new OpenAIPromptExecutionSettings
{
    Temperature = 1.5
};
Casos de uso:
– 0.0-0.3: Clasificación, extracción de datos, respuestas precisas
– 0.4-0.7: Conversaciones naturales, asistentes
– 0.8-1.2: Contenido creativo, brainstorming
– 1.3-2.0: Muy experimental (raramente usado)
Limita la longitud de la respuesta:
var settings = new OpenAIPromptExecutionSettings
{
    MaxTokens = 150  // Aproximadamente 100-120 palabras
};

// Reglas generales:
// - 1 token ≈ 0.75 palabras en inglés
// - 1 token ≈ 0.6 palabras en español
// - GPT-4: max 8,192 tokens (entrada + salida)
// - GPT-4-32k: max 32,768 tokensControla la diversidad considerando probabilidad acumulativa:
var settings = new OpenAIPromptExecutionSettings
{
    TopP = 0.9  // Considera tokens que suman hasta 90% de probabilidad
};

// Valores típicos:
// - 0.1: Muy conservador
// - 0.9: Estándar (recomendado)
// - 1.0: Considera todas las opcionesNota: Generalmente se usa temperature O top_p, no ambos.
var settings = new OpenAIPromptExecutionSettings
{
    FrequencyPenalty = 0.5f,  // Reduce repetición de tokens frecuentes (-2.0 a 2.0)
    PresencePenalty = 0.5f    // Fomenta temas nuevos (-2.0 a 2.0)
};

// Frequency Penalty: Penaliza por frecuencia de uso
// Presence Penalty: Penaliza por presencia (sí/no), sin importar frecuenciavar classificationSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.1, // Muy baja para consistencia
MaxTokens = 50, // Respuestas cortas
TopP = 0.1, // Muy conservador
FrequencyPenalty = 0,
PresencePenalty = 0
};
var prompt = """
Clasifica el siguiente texto en una de estas categorías: deportes, tecnología, política.
Texto: {{$text}}
Categoría:
""";var chatSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.7, // Balance entre creatividad y coherencia
MaxTokens = 500, // Respuestas medianas
TopP = 0.9,
FrequencyPenalty = 0.3f, // Evitar repetición moderada
PresencePenalty = 0.3f // Fomentar variedad
};var creativeSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.9, // Alta creatividad
MaxTokens = 1000, // Respuestas largas
TopP = 0.95,
FrequencyPenalty = 0.5f,
PresencePenalty = 0.5f
};var extractionSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.0, // Determinístico
MaxTokens = 200,
ResponseFormat = "json_object", // Formato estructurado
FrequencyPenalty = 0,
PresencePenalty = 0
};var summarySettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.3, // Baja, pero permite algo de variación
MaxTokens = 300,
TopP = 0.8,
FrequencyPenalty = 0.2f,
PresencePenalty = 0.2f
};var codeSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.2, // Preciso pero con algo de flexibilidad
MaxTokens = 1500,
TopP = 0.9,
FrequencyPenalty = 0,
PresencePenalty = 0
};public class LLMConfigurationService
{
public enum TaskType
{
Classification,
Conversation,
Creative,
Extraction,
Summary,
Code,
Translation
}
public OpenAIPromptExecutionSettings GetSettingsForTask(TaskType taskType)
{
return taskType switch
{
TaskType.Classification => new OpenAIPromptExecutionSettings
{
Temperature = 0.1f,
MaxTokens = 50,
TopP = 0.1f,
FrequencyPenalty = 0,
PresencePenalty = 0
},
TaskType.Conversation => new OpenAIPromptExecutionSettings
{
Temperature = 0.7f,
MaxTokens = 500,
TopP = 0.9f,
FrequencyPenalty = 0.3f,
PresencePenalty = 0.3f
},
TaskType.Creative => new OpenAIPromptExecutionSettings
{
Temperature = 0.9f,
MaxTokens = 1000,
TopP = 0.95f,
FrequencyPenalty = 0.5f,
PresencePenalty = 0.5f
},
TaskType.Extraction => new OpenAIPromptExecutionSettings
{
Temperature = 0.0f,
MaxTokens = 200,
ResponseFormat = "json_object",
FrequencyPenalty = 0,
PresencePenalty = 0
},
TaskType.Summary => new OpenAIPromptExecutionSettings
{
Temperature = 0.3f,
MaxTokens = 300,
TopP = 0.8f,
FrequencyPenalty = 0.2f,
PresencePenalty = 0.2f
},
TaskType.Code => new OpenAIPromptExecutionSettings
{
Temperature = 0.2f,
MaxTokens = 1500,
TopP = 0.9f,
FrequencyPenalty = 0,
PresencePenalty = 0
},
TaskType.Translation => new OpenAIPromptExecutionSettings
{
Temperature = 0.3f,
MaxTokens = 1000,
TopP = 0.9f,
FrequencyPenalty = 0,
PresencePenalty = 0
},
_ => new OpenAIPromptExecutionSettings
{
Temperature = 0.7f,
MaxTokens = 500
}
};
}
}public class TokenEstimator
{
// Estimación aproximada (no exacta)
public int EstimateTokens(string text)
{
// Regla simple: ~1.3 caracteres por token en español
return (int)Math.Ceiling(text.Length / 1.3);
}
public bool WillFitInContext(string prompt, string response, int maxContextTokens = 8192)
{
var promptTokens = EstimateTokens(prompt);
var responseTokens = EstimateTokens(response);
return (promptTokens + responseTokens) < maxContextTokens;
}
public int CalculateMaxResponseTokens(string prompt, int maxContextTokens = 8192, int safetyMargin = 100)
{
var promptTokens = EstimateTokens(prompt);
return Math.Max(0, maxContextTokens - promptTokens - safetyMargin);
}
}public class CostOptimizedLLMService
{
private readonly Kernel _kernel;
private readonly TokenEstimator _tokenEstimator;
public async Task<string> GenerateWithCostLimitAsync(
string prompt,
int maxCostTokens = 1000)
{
var estimatedPromptTokens = _tokenEstimator.EstimateTokens(prompt);
var remainingTokens = maxCostTokens - estimatedPromptTokens;
if (remainingTokens <= 0)
{
throw new InvalidOperationException("Prompt excede límite de costo");
}
var settings = new OpenAIPromptExecutionSettings
{
Temperature = 0.7f,
MaxTokens = Math.Min(remainingTokens, 500) // Limitar respuesta
};
var function = _kernel.CreateFunctionFromPrompt(prompt, settings);
var result = await _kernel.InvokeAsync(function);
return result.GetValue<string>() ?? string.Empty;
}
}public class SettingsTester
{
private readonly Kernel _kernel;
public async Task<SettingsTestResult> TestSettingsAsync(
string prompt,
List<OpenAIPromptExecutionSettings> settingsVariations,
int iterations = 3)
{
var results = new List<TestIteration>();
foreach (var settings in settingsVariations)
{
var responses = new List<string>();
for (int i = 0; i < iterations; i++)
{
var function = _kernel.CreateFunctionFromPrompt(prompt, settings);
var result = await _kernel.InvokeAsync(function);
responses.Add(result.GetValue<string>() ?? "");
}
results.Add(new TestIteration
{
Settings = settings,
Responses = responses,
Consistency = CalculateConsistency(responses),
AverageLength = responses.Average(r => r.Length)
});
}
return new SettingsTestResult
{
Iterations = results,
BestSettings = results.OrderByDescending(r => r.Consistency).First().Settings
};
}
private double CalculateConsistency(List<string> responses)
{
// Implementación simplificada
if (responses.Count < 2) return 1.0;
var firstLength = responses[0].Length;
var variance = responses.Average(r => Math.Abs(r.Length - firstLength));
return 1.0 - (variance / firstLength);
}
}
public class TestIteration
{
public required OpenAIPromptExecutionSettings Settings { get; init; }
public required List<string> Responses { get; init; }
public double Consistency { get; init; }
public double AverageLength { get; init; }
}
public class SettingsTestResult
{
public required List<TestIteration> Iterations { get; init; }
public required OpenAIPromptExecutionSettings BestSettings { get; init; }
}public class SettingsMonitor
{
private readonly Dictionary<string, SettingsMetrics> _metrics = new();
public void TrackRequest(
string configName,
OpenAIPromptExecutionSettings settings,
int promptTokens,
int completionTokens,
TimeSpan latency)
{
if (!_metrics.ContainsKey(configName))
{
_metrics[configName] = new SettingsMetrics { ConfigName = configName };
}
var metrics = _metrics[configName];
metrics.TotalRequests++;
metrics.TotalPromptTokens += promptTokens;
metrics.TotalCompletionTokens += completionTokens;
metrics.TotalLatencyMs += latency.TotalMilliseconds;
metrics.LastUsed = DateTime.UtcNow;
}
public SettingsMetrics GetMetrics(string configName)
{
return _metrics.GetValueOrDefault(configName) ?? new SettingsMetrics { ConfigName = configName };
}
public List<SettingsMetrics> GetAllMetrics()
{
return _metrics.Values.OrderByDescending(m => m.TotalRequests).ToList();
}
}
public class SettingsMetrics
{
public required string ConfigName { get; init; }
public long TotalRequests { get; set; }
public long TotalPromptTokens { get; set; }
public long TotalCompletionTokens { get; set; }
public double TotalLatencyMs { get; set; }
public DateTime? LastUsed { get; set; }
public double AveragePromptTokens => TotalRequests > 0 ? (double)TotalPromptTokens / TotalRequests : 0;
public double AverageCompletionTokens => TotalRequests > 0 ? (double)TotalCompletionTokens / TotalRequests : 0;
public double AverageLatencyMs => TotalRequests > 0 ? TotalLatencyMs / TotalRequests : 0;
}// ✅ Empezar con settings conservadores
var initialSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.5f, // Medio
MaxTokens = 300 // Moderado
};
// Ajustar basándose en resultados/// <summary>
/// Configuración para clasificación de tickets de soporte.
/// Temperature baja (0.1) para consistencia en categorías.
/// MaxTokens limitado (50) ya que solo necesitamos nombre de categoría.
/// </summary>
var ticketClassificationSettings = new OpenAIPromptExecutionSettings
{
Temperature = 0.1f,
MaxTokens = 50
};public async Task<string> ABTestSettingsAsync(string prompt)
{
var settingsA = new OpenAIPromptExecutionSettings { Temperature = 0.5f };
var settingsB = new OpenAIPromptExecutionSettings { Temperature = 0.7f };
// Alternar entre configuraciones y medir resultados
var useA = Random.Shared.Next(2) == 0;
var settings = useA ? settingsA : settingsB;
// Trackear qué configuración se usó
TrackConfigUsage(useA ? "A" : "B");
var function = _kernel.CreateFunctionFromPrompt(prompt, settings);
return (await _kernel.InvokeAsync(function)).GetValue<string>() ?? "";
}La configuración correcta de temperatura, tokens y otros parámetros es crucial para obtener resultados óptimos de LLMs. Cada caso de uso requiere un balance diferente entre creatividad, consistencia y costo. Experimenta con diferentes configuraciones, mide resultados, y ajusta basándote en datos reales.
Palabras clave: LLM configuration, temperature, tokens, top_p, GPT-4, prompt settings, OpenAI parameters
Una carta QR con panel por restaurante y lectura de fotos mediante Gemini. Código abierto, edición manual y revisión antes de incorporar platos.
Luca Cantón ha creado LO-E, un hub donde convierte las ideas de videojuegos que le van pasando por la cabeza en siete mundos jugables desde el navegador.
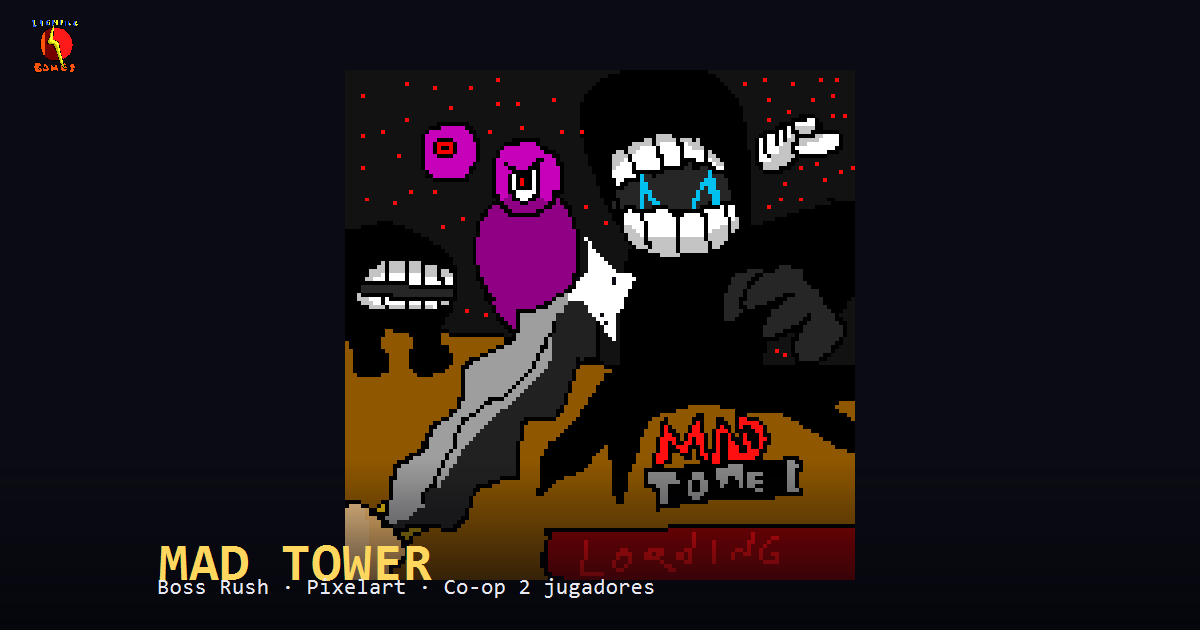
Leo Cantón tiene 14 años y ha convertido el videojuego que llevaba años diseñando en papel en MAD TOWER, un boss rush 2D creado con ayuda de la IA.